Schweizerdeutsche Spracherkennung in State-of-the-Art Qualität
Unsere API transkribiert Schweizerdeutsch, Deutsch, Französisch, Italienisch, Englisch und viele weitere Sprachen – in der Schweiz betrieben, revDSG- und GDPR-konform, mit Sprechererkennung, automatischer Spracherkennung und akkuraten Zeitstempeln.
State-of-the-Art Qualität für alle Dialektregionen
Wir haben umfassende, qualitativ hochwertige eigene Trainingsdaten für Schweizerdeutsch und decken damit alle schweizerdeutschen Dialektregionen ab: Basel, Bern, Graubünden, Ostschweiz, Wallis, Zentralschweiz, Zürich. Damit trainieren wir unsere Spracherkennung und erreichen so State-of-the-Art Qualität für alle Dialektregionen.
Unsere asynchrone REST-API. In einer Stunde integriert.
Audio hochladen, Request-ID erhalten, Resultat abholen – segmentiert, mit Sprechererkennung und akkuraten Wort-Zeitstempeln.
Sie können die API direkt im Browser über die API-Dokumentation testen. Für längere Aufnahmen ab 5 Minuten empfiehlt es sich, programmatisch zu testen, z.B. via curl. Beim Test über die OpenAPI Dokumentation werden direkt die ausgeführten curl Commands angezeigt.
Verfügbare Modelle:
- - whisper-ch: auf Schweizerdeutsch spezialisiertes Modell
- - whisper-orig: breit aufgestelltes Standardmodell, empfohlen für Audio ohne Schweizerdeutsch
- - Modell-Parameter nicht gesetzt: whisper-ch wenn language = de-CH, ansonsten whisper-orig
{
  "state": 0,
  "message": "Request successfully completed",
  "response": {
    "content_format": "json",
    "content": [
      {
        "start": "00:00:00.4520000",
        "end": "00:00:06.3820000",
        "transcript": "Wie viele Kilometer hast du mit deinem Auto schon gemacht inzwischen?",
        "speaker_id": 1,
        "words": [
          {
            "start": "00:00:00.4520000",
            "end": "00:00:00.6720000",
            "transcript": "Wie",
            "speaker_id": 1,
            "score": 0.545
          },
          {
            "start": "00:00:00.6920000",
            "end": "00:00:00.9130000",
            "transcript": "viele",
            "speaker_id": 1,
            "score": 0.481
          },
          {
            "start": "00:00:00.9530000",
            "end": "00:00:01.7340000",
            "transcript": "Kilometer",
            "speaker_id": 1,
            "score": 0.787
          },
          {
            "start": "00:00:01.7740000",
            "end": "00:00:01.9340000",
            "transcript": "hast",
            "speaker_id": 1,
            "score": 0.199
          },
          {
            "start": "00:00:02.0550000",
            "end": "00:00:02.1550000",
            "transcript": "du",
            "speaker_id": 1,
            "score": 0.522
          },
          {
            "start": "00:00:02.1750000",
            "end": "00:00:02.4150000",
            "transcript": "mit",
            "speaker_id": 1,
            "score": 0.631
          },
          {
            "start": "00:00:02.4550000",
            "end": "00:00:02.6560000",
            "transcript": "deinem",
            "speaker_id": 1,
            "score": 0.356
          },
          {
            "start": "00:00:02.6760000",
            "end": "00:00:03.0560000",
            "transcript": "Auto",
            "speaker_id": 1,
            "score": 0.826
          },
          {
            "start": "00:00:03.0760000",
            "end": "00:00:03.2370000",
            "transcript": "schon",
            "speaker_id": 1,
            "score": 0.521
          },
          {
            "start": "00:00:03.2570000",
            "end": "00:00:03.6970000",
            "transcript": "gemacht",
            "speaker_id": 1,
            "score": 0.603
          },
          {
            "start": "00:00:03.7370000",
            "end": "00:00:06.3820000",
            "transcript": "inzwischen?",
            "speaker_id": 1,
            "score": 0.75
          }
        ]
      },
      {
        "start": "00:00:06.4220000",
        "end": "00:00:09.7280000",
        "transcript": "Aktuell hat er noch keine 30000 Kilometer auf dem Tacho.",
        "speaker_id": 0,
        "words": [
          {
            "start": "00:00:06.4220000",
            "end": "00:00:06.9630000",
            "transcript": "Aktuell",
            "speaker_id": 0,
            "score": 0.734
          },
          {
            "start": "00:00:06.9830000",
            "end": "00:00:07.1030000",
            "transcript": "hat",
            "speaker_id": 0,
            "score": 0.65
          },
          {
            "start": "00:00:07.1430000",
            "end": "00:00:07.2240000",
            "transcript": "er",
            "speaker_id": 0,
            "score": 0.775
          },
          {
            "start": "00:00:07.2640000",
            "end": "00:00:07.3840000",
            "transcript": "noch",
            "speaker_id": 0,
            "score": 0.654
          },
          {
            "start": "00:00:07.4240000",
            "end": "00:00:07.7040000",
            "transcript": "keine",
            "speaker_id": 0,
            "score": 0.692
          },
          {
            "start": "00:00:07.7850000",
            "end": "00:00:08.5060000",
            "transcript": "30000",
            "speaker_id": 0,
            "score": 0.757
          },
          {
            "start": "00:00:08.5460000",
            "end": "00:00:09.0070000",
            "transcript": "Kilometer",
            "speaker_id": 0,
            "score": 0.678
          },
          {
            "start": "00:00:09.0670000",
            "end": "00:00:09.1470000",
            "transcript": "auf",
            "speaker_id": 0,
            "score": 0.363
          },
          {
            "start": "00:00:09.1670000",
            "end": "00:00:09.3470000",
            "transcript": "dem",
            "speaker_id": 0,
            "score": 0.385
          },
          {
            "start": "00:00:09.3870000",
            "end": "00:00:09.7280000",
            "transcript": "Tacho.",
            "speaker_id": 0,
            "score": 0.323
          }
        ]
      }
    ],
    "language": "de-CH",
    "speaker_count": 2,
    "duration": "00:00:10.4080000",
    "measured_duration": "00:00:09.2360000",
    "input_size": 333056,
    "message": ""
  }
}
Komfortable Weboberfläche und Editor gefällig?
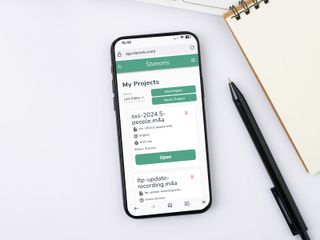
Sie möchten dieselbe Spracherkennungs-Qualität, aber mit komfortabler Weboberfläche zur Bedienung und Editor zur manuellen Perfektionierung der Transkripte? Dann ist Stenoris wie geschaffen für Sie.
Die Lösung für Parlamente und Kommissionen
Zusammen mit unserer Partnerfirma it-processing AG bieten wir mit Verbalix eine professionelle Protokollierungslösung für politische Gremien wie Parlamente und Kommissionen an.
Sparen Sie wertvolle Zeit bei der Protokollierung von Sitzungen durch unsere eingebaute Spracherkennung - auch hier selbstverständlich mit Schweizerdeutsch-Unterstützung in State-of-the-Art Qualität. Die Spracherkennung läuft bei Verbalix mit einem speziell für politische Gremien optimierten Modell.
Unsere Kundinnen und Kunden
«Die Qualität der Transkription von Schweizer- auf Hochdeutsch ist unseres Erachtens auf sehr hohem Niveau und wirklich beeindruckend.»
«Als einer der ersten Kunden von Ateleris für unsere Bestellungsautomation sind wir absolut happy mit dem Service! Er ist schnell, preiswert und die Transkriptionsqualität ist hochwertig. Dazu kommt ein Team, dem seine Kunden am Herzen liegen.»
An vorderster Front bei schweizerdeutscher Spracherkennung - seit 2019
Die Ateleris-Expert:innen Michel Plüss und Julia Hartmann waren an sieben Publikationen zu schweizerdeutscher Spracherkennung massgeblich beteiligt. Bei sechs davon stellten sie den Erstautor.
Forschung und Engineering in einem Team
Am Puls der Forschung
Unser Team publiziert selbst zu schweizerdeutscher Spracherkennung und arbeitet eng mit dem Institut für Data Science der FHNW zusammen. Neue Methoden landen schnell im Produkt.
MLOps statt Einzelexperimente
Versionierte Daten, reproduzierbare Trainings, automatische Evaluation auf festen Testsets. Jedes Release ist messbar besser oder wird nicht ausgeliefert.
Aktuelle Modelle
Wir verfolgen laufend neue Architekturen und trainieren sie auf unseren Daten weiter. Verbesserungen stehen Ihnen automatisch über dieselbe API zur Verfügung – ganz ohne Migrationsaufwand.
Qualität wie im Raumfahrtprojekt
Wir entwickeln auch Software für ESA-Missionen. Code-Reviews, Tests und Dokumentation nach denselben Standards gelten für unseren Transkriptionsdienst.
Testen Sie mit Ihren eigenen Aufnahmen.
Wir schicken Ihnen gerne einen Test API Key und beantworten Ihre offenen Fragen.